Apple silicon
Apple Mac Studio (M5 Max)
- Memoria
- 128 GB
- Ancho de banda
- 614 GB/s
Mayor modelo popular a 4 bits: Qwen3.5 122B A10B
128 GB a 614 GB/s: gpt-oss-120b y MoE de 122B a buen ritmo, casi sin ruido.
Todas las tarjetas gráficas, Mac, mini PC y placas edge que merece la pena considerar para ejecutar modelos de lenguaje en local, con memoria, ancho de banda, software y precios.
33 plataformas
Apple silicon
Mayor modelo popular a 4 bits: Qwen3.5 122B A10B
128 GB a 614 GB/s: gpt-oss-120b y MoE de 122B a buen ritmo, casi sin ruido.

GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.6 35B A3B
La tarjeta doméstica más rápida para IA local: 32 GB y 1,8 TB/s hacen volar los modelos de 30B.
Apple silicon
Mayor modelo popular a 4 bits: Qwen3.5 397B A17B
Hasta 512 GB a 1,2 TB/s: el único equipo que carga DeepSeek R1 o Qwen3.5 397B a 4 bits por sí solo.
GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.5 122B A10B
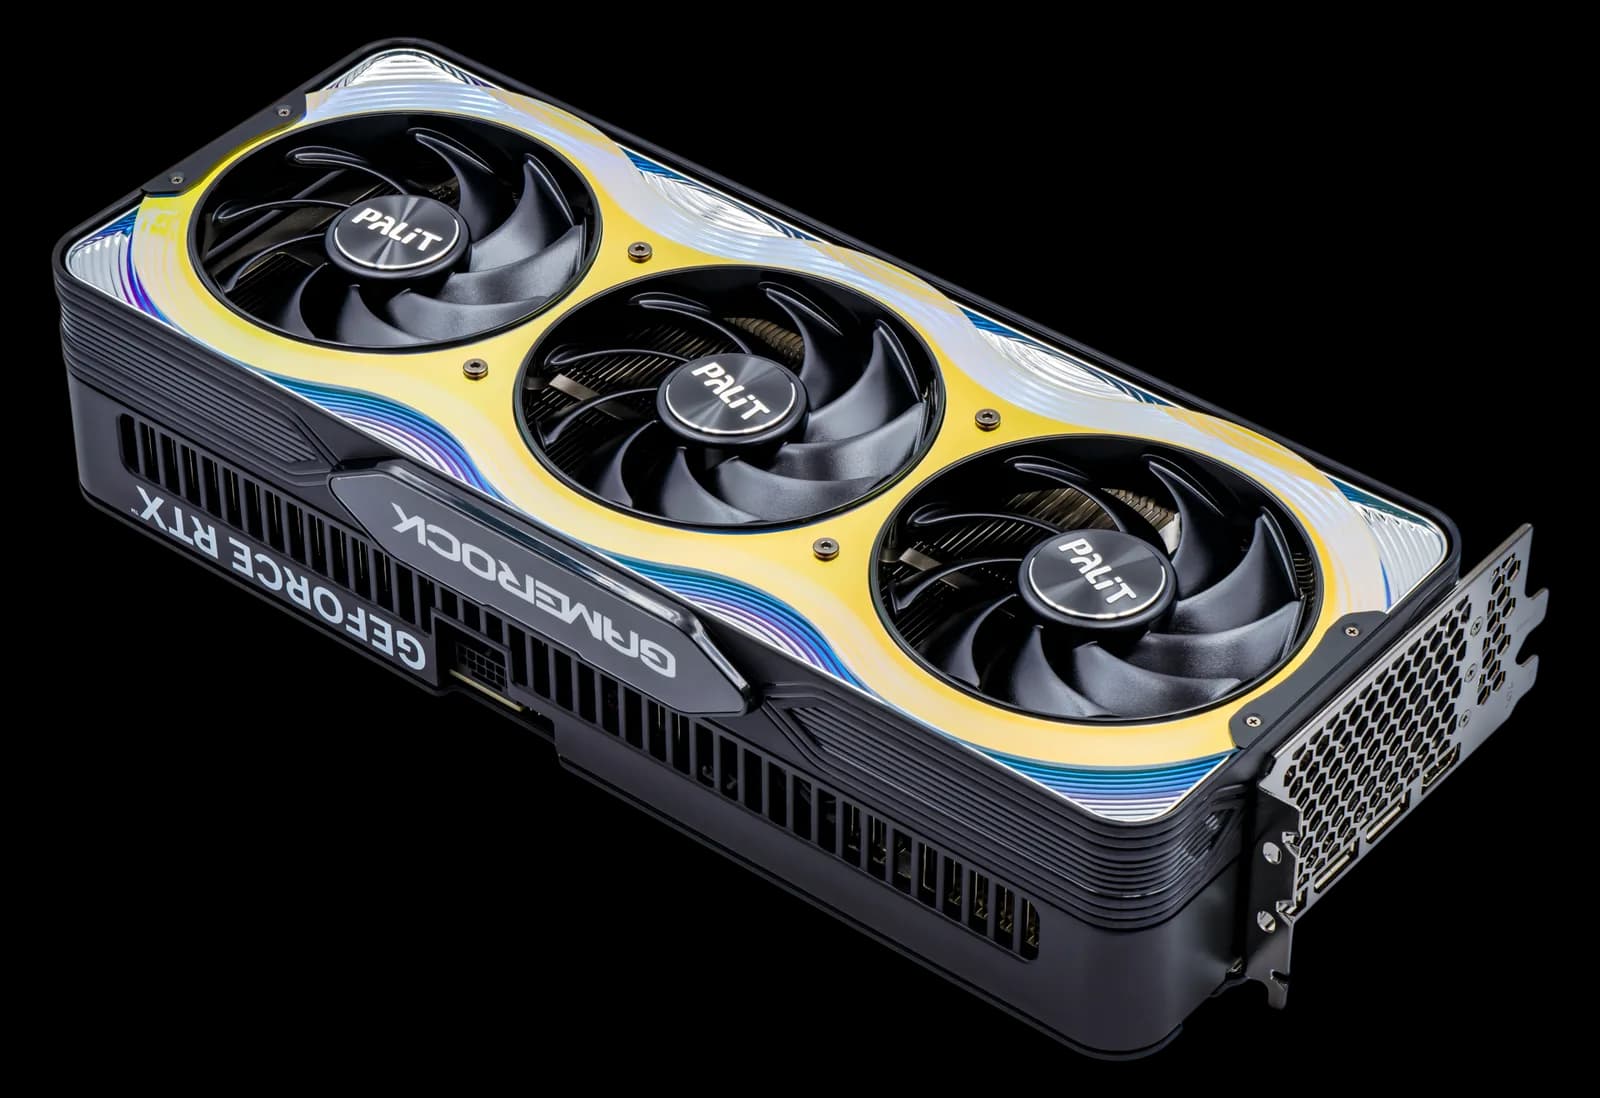
96 GB en una tarjeta a la velocidad de una RTX 5090: gpt-oss-120b y MoE de 122B enteros en la GPU.
Ryzen AI
Mayor modelo popular a 4 bits: Qwen3.5 122B A10B
128 GB de memoria unificada en un mini PC por menos que un Mac Studio: el favorito del homelab para modelos MoE.
GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.6 27B
El clásico del homelab: 24 GB y 936 GB/s, comprada de segunda mano. Con dos tienes 48 GB.

DGX Spark / GB10
Mayor modelo popular a 4 bits: Qwen3.5 122B A10B
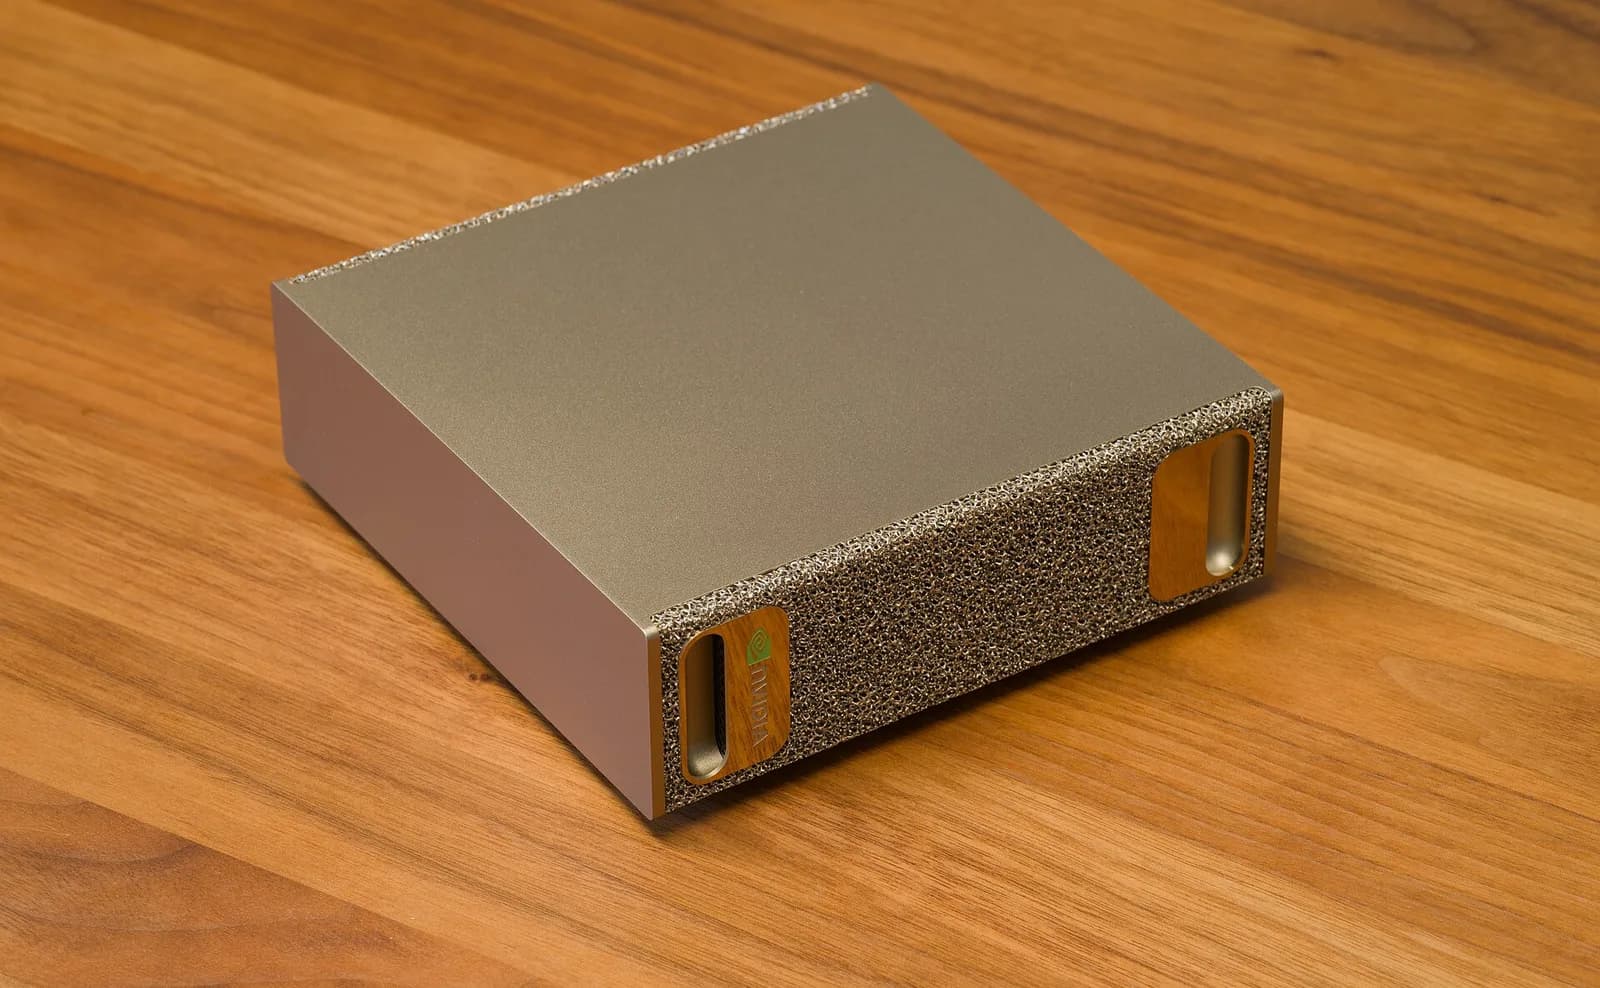
128 GB con CUDA en una caja diminuta: la respuesta de NVIDIA a Strix Halo y al Mac.
GPU AMD
Mayor modelo popular a 4 bits: Qwen3.6 35B A3B
32 GB por un tercio de lo que cuesta una RTX 5090: la tarjeta nueva de 32 GB más barata.

GPU NVIDIA
Mayor modelo popular a 4 bits: gpt-oss-20b
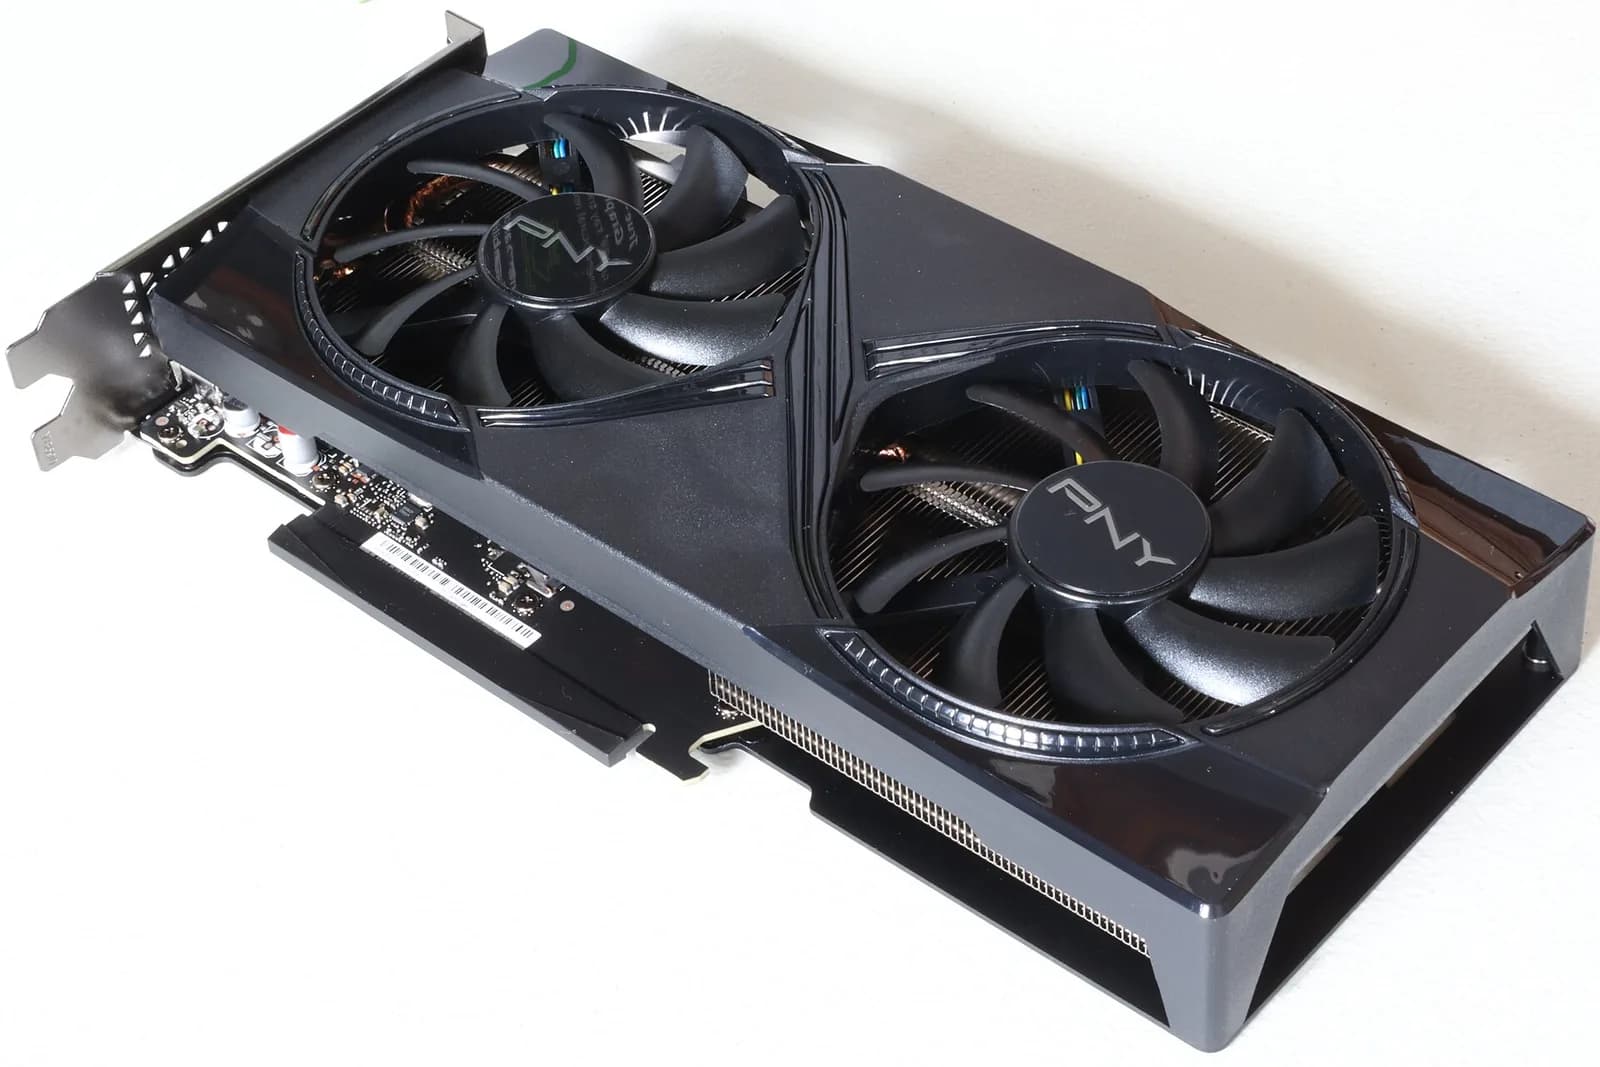
La NVIDIA nueva más barata con 16 GB. Bajo consumo y CUDA: la forma fácil de empezar.
GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.6 35B A3B
48 GB en una tarjeta de turbina de 300 W: modelos densos de 70B en una sola GPU.
Apple silicon
Mayor modelo popular a 4 bits: Qwen3.6 35B A3B
Hasta 64 GB a 307 GB/s en un mini PC silencioso: modelos de 27–35B a buen ritmo.
GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.6 27B
24 GB en una tarjeta de una ranura y 140 W: la forma más «homelab» de tener 24 GB nuevos.
GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.6 35B A3B
32 GB con solo 200 W: la capacidad de una RTX 5090 con la mitad de calor.

GPU AMD
Mayor modelo popular a 4 bits: Qwen3.6 27B
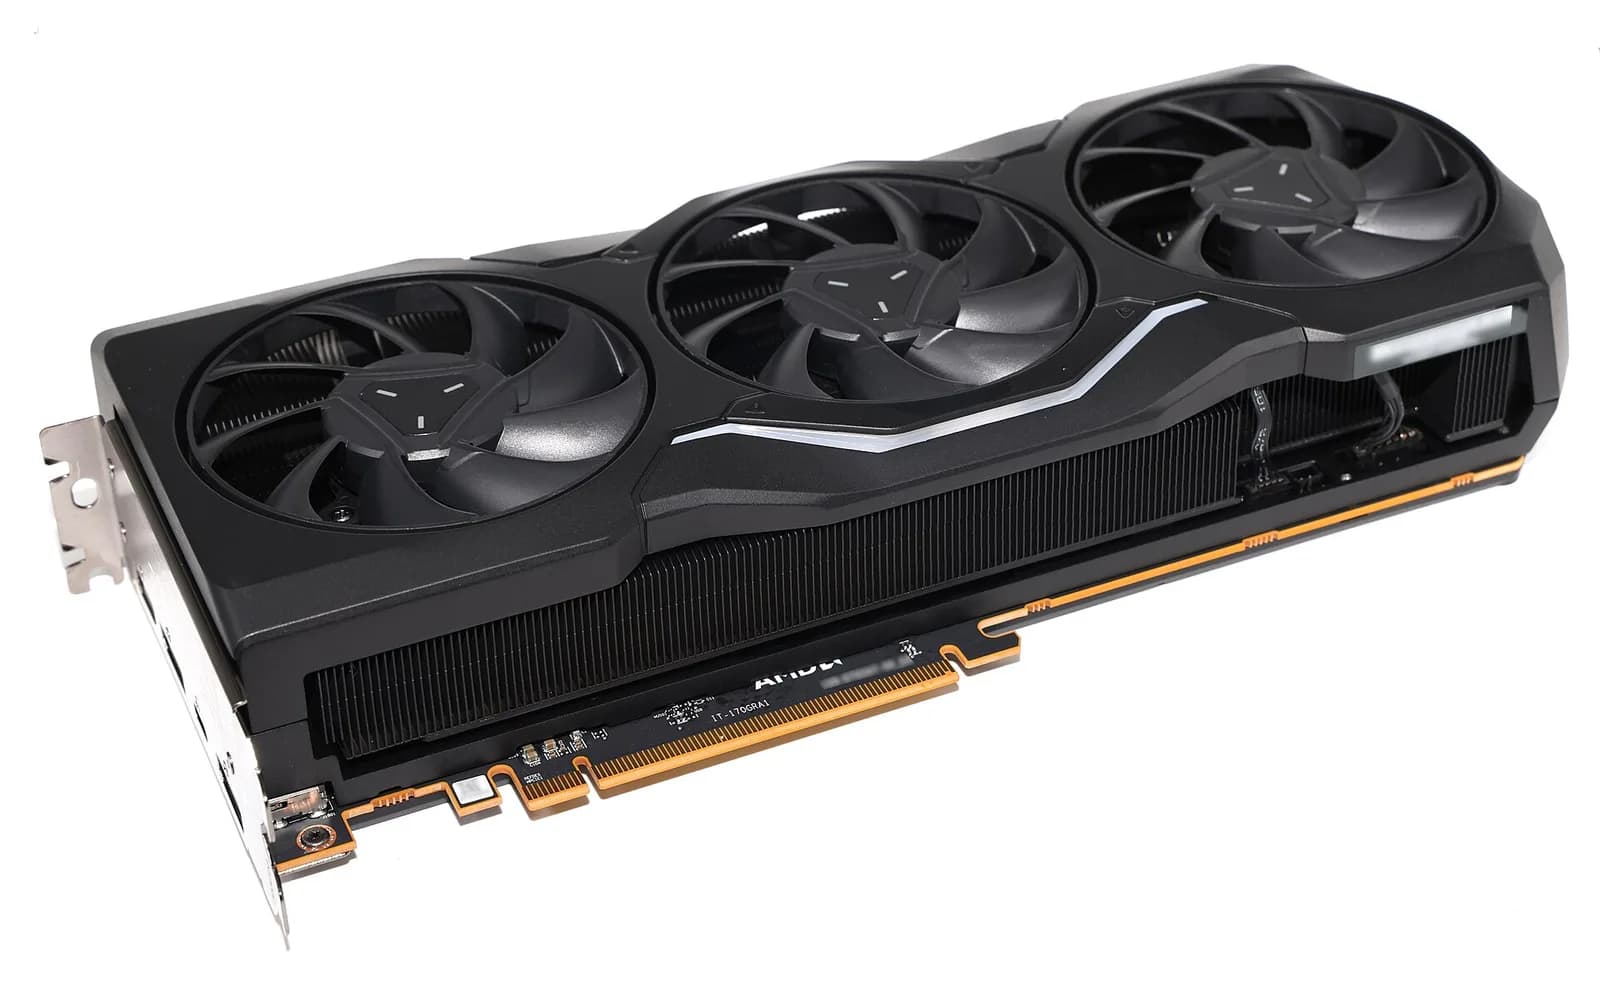
24 GB y 960 GB/s: memoria del nivel de una RTX 3090, pero nueva.
Ryzen AI
Mayor modelo popular a 4 bits: Qwen3.5 122B A10B
El sucesor de Strix Halo con hasta 192 GB (160 GB para la GPU): Qwen3 235B en un mini PC.
GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.6 27B
Ya no se fabrica, pero sigue siendo de las mejores para IA: 24 GB a 1 TB/s.
GPU Intel
Mayor modelo popular a 4 bits: Qwen3.6 35B A3B
El Battlemage grande de Intel: 32 GB y 608 GB/s por menos que la R9700 de AMD.
GPU NVIDIA
Mayor modelo popular a 4 bits: gpt-oss-20b
Casi el ancho de banda de la RTX 5080 por menos dinero. Sigue teniendo 16 GB: velocidad, no tamaño.

GPU AMD
Mayor modelo popular a 4 bits: gpt-oss-20b
La mejor tarjeta de AMD para jugar también es una buena opción de 16 GB para IA, con ROCm y Vulkan.
GPU AMD
Mayor modelo popular a 4 bits: gpt-oss-20b
La tarjeta nueva de 16 GB más barata. Memoria lenta, pero carga lo mismo que una RTX 5060 Ti.
GPU Intel
Mayor modelo popular a 4 bits: Qwen3.6 27B
La tarjeta nueva de 24 GB más barata, si te apañas con el software de Intel.
IA edge
Mayor modelo popular a 4 bits: Qwen3.5 122B A10B
Ordenador para robótica con 128 GB y Blackwell. Con LLM rinde como un DGX Spark.
Apple silicon
Mayor modelo popular a 4 bits: Qwen3.6 27B
Una caja diminuta y silenciosa, siempre encendida, para modelos pequeños. Si es para IA, elige 32 GB.

GPU NVIDIA
Mayor modelo popular a 4 bits: Gemma 4 12B
La forma más barata de tener CUDA con 12 GB. Lenta, pero suficiente para modelos de 7–12B.
GPU Intel
Mayor modelo popular a 4 bits: gpt-oss-20b
16 GB en una tarjeta de perfil bajo, 70 W y sin cable de alimentación: pensada para servidores pequeños.
IA edge
Mayor modelo popular a 4 bits: Ninguno de nuestros modelos populares
Una placa CUDA de 25 W que mueve modelos de 1–4B: proyectos de robótica y domótica, no un chat potente.

GPU Intel
Mayor modelo popular a 4 bits: Gemma 4 12B
12 GB con buen ancho de banda por poco dinero; el problema es el software.
Ryzen AI
Mayor modelo popular a 4 bits: Qwen3.5 122B A10B
Los mini PC y NAS Ryzen AI de gama media: hasta 96 GB de DDR5 normal, bien para modelos de 8–30B y MoE pequeños, lentos con los densos grandes.
GPU NVIDIA
Mayor modelo popular a 4 bits: gpt-oss-20b
Rápida, pero solo 16 GB: la misma memoria que tarjetas que cuestan un tercio.

IA edge
Mayor modelo popular a 4 bits: Llama 3.3 70B
64 GB con CUDA y 60 W. Para LLM, hoy la superan Strix Halo y el Mac mini.
IA edge
Mayor modelo popular a 4 bits: Qwen3 1.7B
Una NPU con 8 GB propios para la Raspberry Pi 5. Solo ejecuta los modelos que compila Hailo, de hasta unos 2B.
GPU NVIDIA
Mayor modelo popular a 4 bits: Gemma 4 12B
Una tarjeta para jugar con solo 12 GB. Para IA compensa más la RTX 5060 Ti de 16 GB.
IA edge
Mayor modelo popular a 4 bits: Qwen3.5 9B
Placas Arm baratas cuya pequeña NPU ejecuta modelos convertidos con RKLLM. Lentas, pero gastan muy poco.