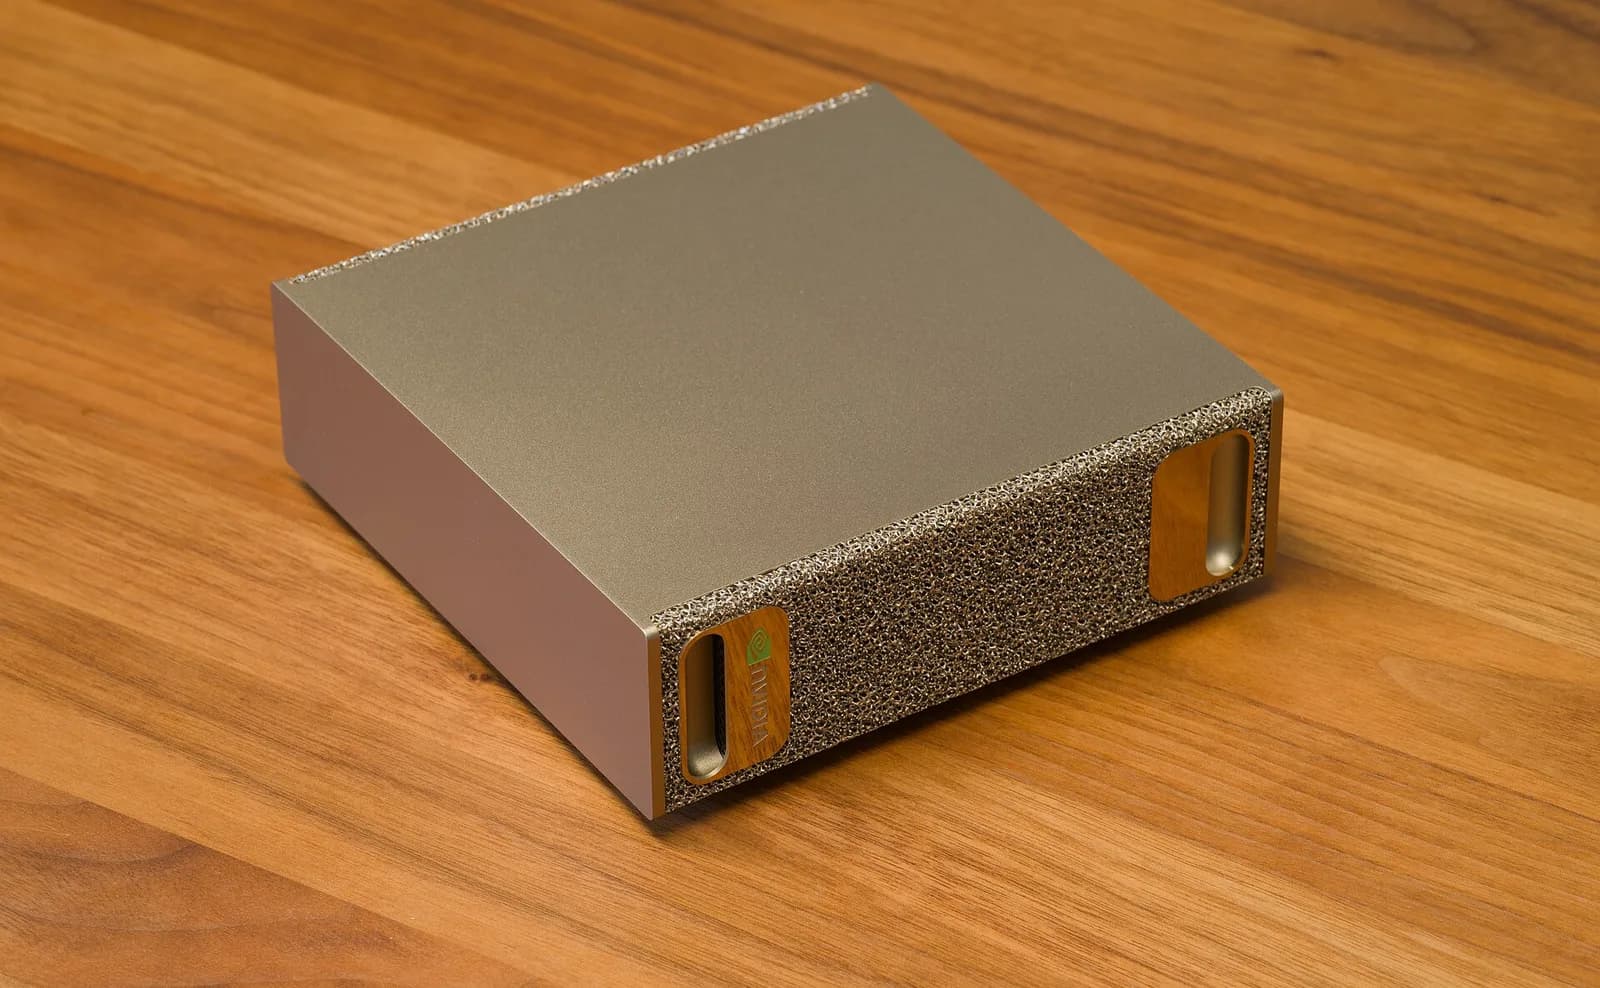
DGX Spark / GB10
NVIDIA GB10 Grace Blackwell (DGX Spark and partners)
- Memoria
- 128 GB
- Ancho de banda
- 273 GB/s
Mayor modelo popular a 4 bits: Qwen3.5 122B A10B
128 GB con CUDA en una caja diminuta: la respuesta de NVIDIA a Strix Halo y al Mac.
NVIDIA · IA edge · 2025
Ordenador para robótica con 128 GB y Blackwell. Con LLM rinde como un DGX Spark.
desde 5499 US$ (precio habitual)
Información de los fabricantes y fuentes públicas; no lo hemos probado.· Revisado el 11 oct 2026
Modelos populares a Q4_K_M con un contexto de 32K tokens. La memoria necesaria sale de los archivos reales del modelo; la velocidad es el techo teórico.
Pesos del modeloCaché de contexto (KV)ProgramaLímite utilizable (color = veredicto)
| Modelo | Veredicto | Memoria | Techo de velocidad |
|---|---|---|---|
| Qwen3 1.7B | Funciona | ≤ 246 tok/s | |
| Qwen3.5 9B | Funciona | ≤ 48 tok/s | |
| Gemma 4 12B | Funciona | ≤ 38 tok/s | |
| gpt-oss-20b | Funciona | ≤ 136 tok/s | |
| Qwen3.6 27B | Funciona | ≤ 16 tok/s | |
| Qwen3.6 35B A3B | Funciona | ≤ 148 tok/s | |
| Llama 3.3 70B | Funciona | ≤ 6 tok/s | |
| gpt-oss-120b | Funciona | ≤ 100 tok/s | |
| Qwen3.5 122B A10B | Funciona | ≤ 45 tok/s | |
| Qwen3.5 397B A17B | No tiene memoria suficiente | — |
Máximo teórico al generar texto: ancho de banda de la memoria dividido entre los bytes que se leen por token. En la práctica se suele alcanzar entre la mitad y tres cuartas partes.
Los precios son referencias editoriales (precio de lanzamiento y un precio habitual en la fecha indicada), no precios en directo. En 2026 la escasez de memoria ha subido muchos precios por encima del de lanzamiento.
Solo mostramos precios actualizados en las últimas 24 horas y pueden cambiar; vale el precio de la tienda al pagar. Podemos recibir una comisión por estos enlaces, sin coste para ti. Afiliación
Ideal para: Robótica e IA física; como servidor de LLM doméstico es mejor un equipo GB10.
Para robótica. Solo para LLM, un DGX Spark o un Strix Halo cuestan menos.
Fuente: Especificaciones del fabricante
Qué tal funcionan hoy las herramientas habituales de IA local (valoración editorial).
Resultados medidos, con su fuente. Nunca inventamos velocidades.
Aún no hay resultados medidos. La tabla de arriba muestra el techo teórico.

DGX Spark / GB10
Mayor modelo popular a 4 bits: Qwen3.5 122B A10B
128 GB con CUDA en una caja diminuta: la respuesta de NVIDIA a Strix Halo y al Mac.
GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.5 122B A10B
96 GB en una tarjeta a la velocidad de una RTX 5090: gpt-oss-120b y MoE de 122B enteros en la GPU.
Ryzen AI
Mayor modelo popular a 4 bits: Qwen3.5 122B A10B
El sucesor de Strix Halo con hasta 192 GB (160 GB para la GPU): Qwen3 235B en un mini PC.