Saltar al contenido
Voltarum Local LLM Hardware Guide

NVIDIA · GPU NVIDIA · 2025

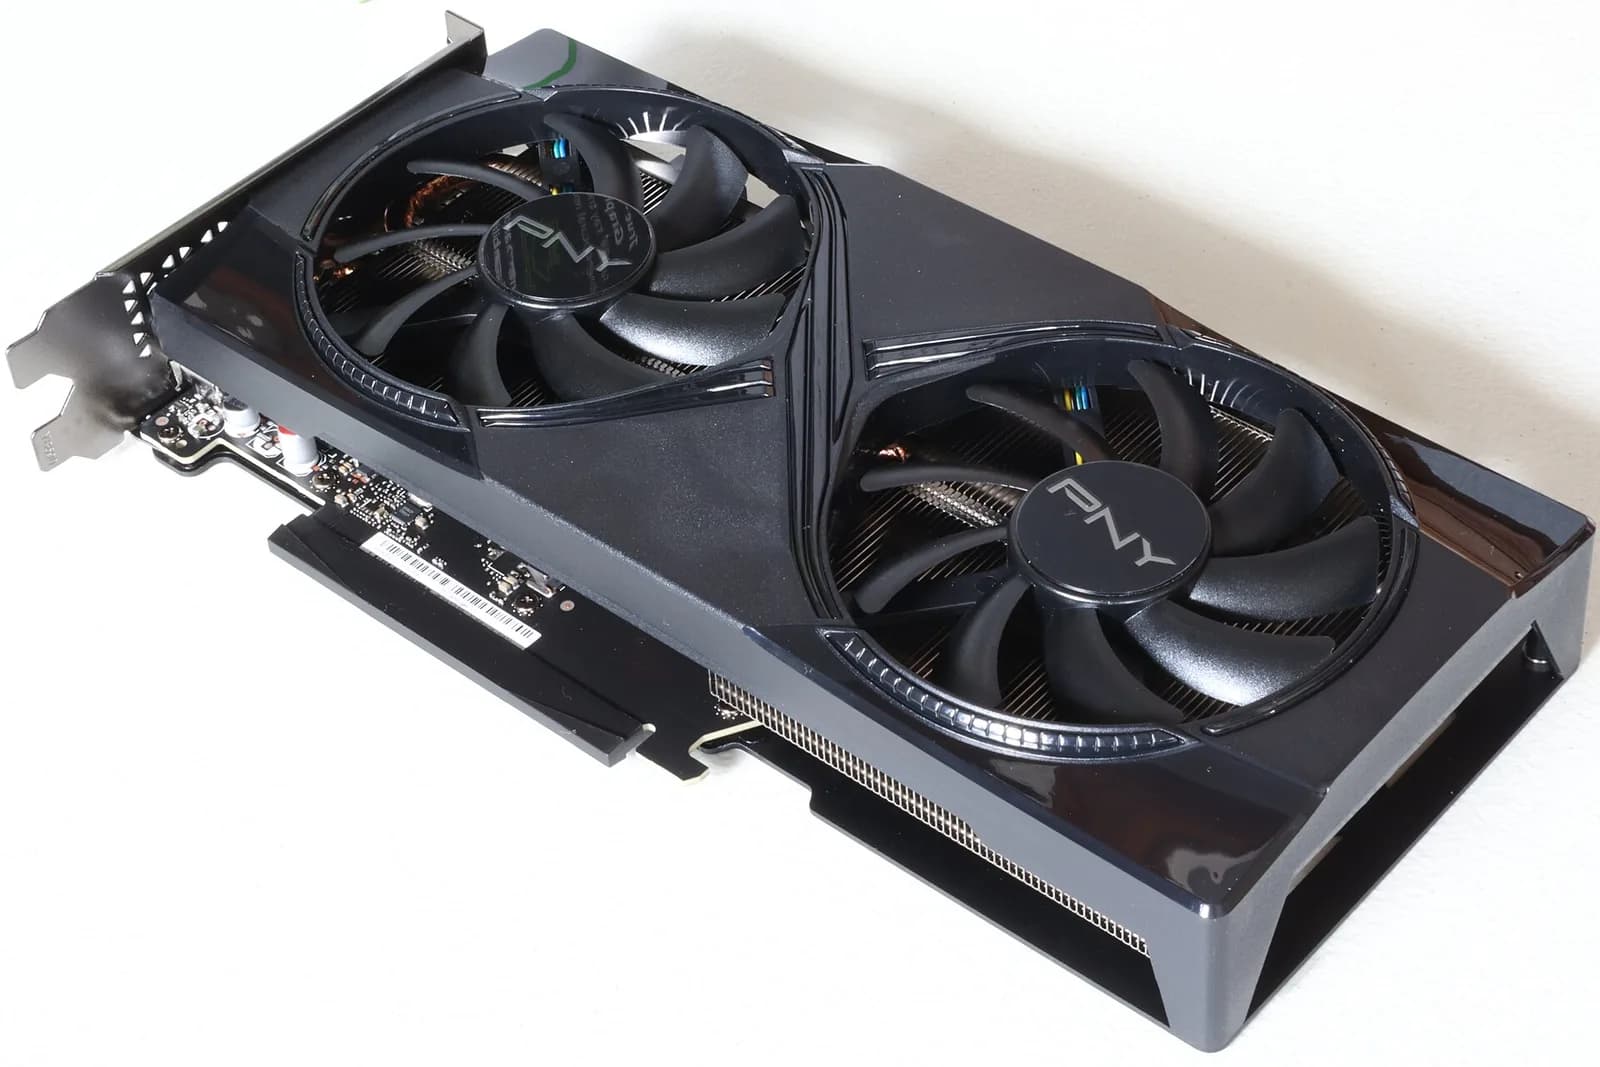
NVIDIA GeForce RTX 5080

No recomendable para IA

Rápida, pero solo 16 GB: la misma memoria que tarjetas que cuestan un tercio.

Memoria
16 GB
Ancho de banda
960 GB/s
Consumo
360 W
Mayor modelo popular a 4 bits
gpt-oss-20b

desde 1830 US$ (precio habitual)

Información de los fabricantes y fuentes públicas; no lo hemos probado.· Revisado el 11 oct 2026

Qué puede ejecutar

Estimación

Modelos populares a Q4_K_M con un contexto de 32K tokens. La memoria necesaria sale de los archivos reales del modelo; la velocidad es el techo teórico.

Cambiar tamaño del modelo o contexto

Pesos del modeloCaché de contexto (KV)ProgramaLímite utilizable (color = veredicto)

ModeloVeredictoMemoriaTecho de velocidad
Qwen3 1.7BFunciona
6,4 GB / 16 GB · con 16 GB
≤ 865 tok/s
Qwen3.5 9BFunciona
8,3 GB / 16 GB · con 16 GB
≤ 169 tok/s
Gemma 4 12BFunciona
9,5 GB / 16 GB · con 16 GB
≤ 135 tok/s
gpt-oss-20bFunciona
14 GB / 16 GB · con 16 GB
≤ 480 tok/s
Qwen3.6 27BNo tiene memoria suficiente
20 GB / 16 GB · con 16 GB
—
Qwen3.6 35B A3BEn parte en la RAM del sistema
24 GB / 16 GB · con 16 GB
—
Llama 3.3 70BNo tiene memoria suficiente
55 GB / 16 GB · con 16 GB
—
gpt-oss-120bEn parte en la RAM del sistema
65 GB / 16 GB · con 16 GB
—
Qwen3.5 122B A10BEn parte en la RAM del sistema
79 GB / 16 GB · con 16 GB
—
Qwen3.5 397B A17BEn parte en la RAM del sistema
247 GB / 16 GB · con 16 GB
—

Máximo teórico al generar texto: ancho de banda de la memoria dividido entre los bytes que se leen por token. En la práctica se suele alcanzar entre la mitad y tres cuartas partes.

Dónde comprar

Los precios son referencias editoriales (precio de lanzamiento y un precio habitual en la fecha indicada), no precios en directo. En 2026 la escasez de memoria ha subido muchos precios por encima del de lanzamiento.

Solo mostramos precios actualizados en las últimas 24 horas y pueden cambiar; vale el precio de la tienda al pagar. Podemos recibir una comisión por estos enlaces, sin coste para ti. Afiliación

Resumen

Opinión

Ideal para: Quien juega y además usa modelos pequeños; para IA sola no compensa.

Opinión¿Lo compraríamos hoy?

Para IA, no. Una RTX 5060 Ti de 16 GB carga los mismos modelos por mucho menos, y una de 24–32 GB carga más.

Ventajas e inconvenientes

Opinión

Ventajas

  • Muy rápida con modelos de hasta unos 14B
  • CUDA y soporte completo

Inconvenientes

  • 16 GB limitan a modelos pequeños y medianos
  • Precio por GB de memoria muy alto en 2026

Especificaciones

Datos
Fabricante
NVIDIA
Chip
GB203
Arquitectura
Blackwell
Tipo
Tarjeta gráfica
Formato
Tarjeta PCIe
Lanzamiento
2025
Disponibilidad
A la venta
Opciones de memoria
16 GB
Tipo de memoria
GDDR7
Bus de memoria
256-bit
Ancho de banda
960 GB/s
Utilizable para modelos (por defecto)
16 GB / 16 GB
Consumo de la tarjeta / máximo
360 W
Interfaz
PCIe 5.0 x16
Ranuras
2
Conector de alimentación
16-pin 12V-2x6
Plataforma de cálculo
CUDA
Modelos
Cualquier modelo que quepa
Varias unidades para un modelo
Sí

Fuente: Especificaciones del fabricante

Software compatible

Opinión

Qué tal funcionan hoy las herramientas habituales de IA local (valoración editorial).

  • llama.cppExcelente
  • OllamaExcelente
  • LM StudioExcelente
  • vLLMExcelente
  • MLXNo compatible

Velocidades medidas

Datos

Resultados medidos, con su fuente. Nunca inventamos velocidades.

Aún no hay resultados medidos. La tabla de arriba muestra el techo teórico.

Alternativas

GPU NVIDIA

NVIDIA GeForce RTX 5060 Ti 16 GB

Memoria
16 GB
Ancho de banda
448 GB/s

Mayor modelo popular a 4 bits: gpt-oss-20b

La NVIDIA nueva más barata con 16 GB. Bajo consumo y CUDA: la forma fácil de empezar.

desde 789 US$ (precio habitual)Buena opción económica

Los mismos 16 GB por mucho menos

GPU NVIDIA

NVIDIA GeForce RTX 3090

Memoria
24 GB
Ancho de banda
936 GB/s

Mayor modelo popular a 4 bits: Qwen3.6 27B

El clásico del homelab: 24 GB y 936 GB/s, comprada de segunda mano. Con dos tienes 48 GB.

desde 1340 US$ (precio habitual)Buena opción económica

24 GB por un precio parecido