GPU NVIDIA
NVIDIA GeForce RTX 5090
- Memoria
- 32 GB
- Ancho de banda
- 1,79 TB/s
Mayor modelo popular a 4 bits: Qwen3.6 35B A3B
La tarjeta doméstica más rápida para IA local: 32 GB y 1,8 TB/s hacen volar los modelos de 30B.
| En esta familia | Memoria | Ancho de banda | Mayor modelo popular a 4 bits | Precio |
|---|---|---|---|---|
| RTX 5090 | 32 GB | 1,79 TB/s | Qwen3.6 35B A3B | 4329 US$ |
| RTX PRO 6000 | 96 GB | 1,79 TB/s | Qwen3.5 122B A10B | 8565 US$ |
| RTX 3090 | 24 GB | 936 GB/s | Qwen3.6 27B | 1340 US$ |
| RTX PRO 5000 | 48 GB | 1,34 TB/s | Qwen3.6 35B A3B | 4500 US$ |
| RTX 5060 Ti 16 GB | 16 GB | 448 GB/s | gpt-oss-20b | 789 US$ |
| RTX PRO 4000 | 24 GB | 672 GB/s | Qwen3.6 27B | 1500 US$ |
| RTX PRO 4500 | 32 GB | 896 GB/s | Qwen3.6 35B A3B | 2500 US$ |
| RTX 4090 | 24 GB | 1,01 TB/s | Qwen3.6 27B | 1599 US$ |
| RTX 5070 Ti | 16 GB | 896 GB/s | gpt-oss-20b | 1190 US$ |
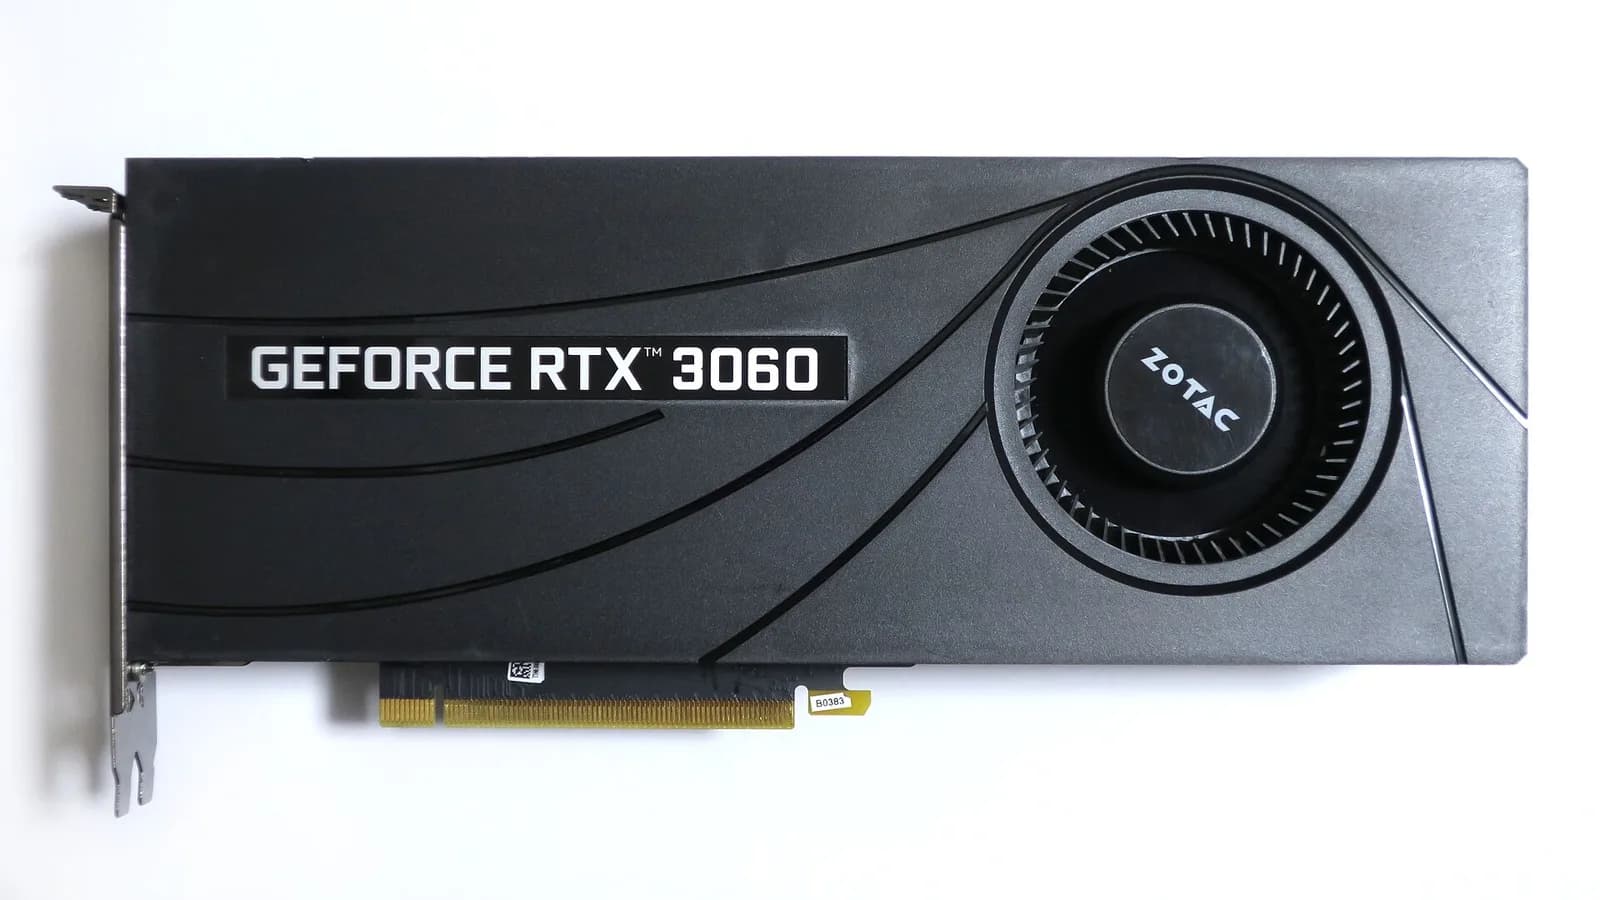
| RTX 3060 12 GB | 12 GB | 360 GB/s | Gemma 4 12B | 329 US$ |
| RTX 5080 | 16 GB | 960 GB/s | gpt-oss-20b | 1830 US$ |
| RTX 5070 | 12 GB | 672 GB/s | Gemma 4 12B | 1010 US$ |

GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.6 35B A3B
La tarjeta doméstica más rápida para IA local: 32 GB y 1,8 TB/s hacen volar los modelos de 30B.
GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.5 122B A10B
96 GB en una tarjeta a la velocidad de una RTX 5090: gpt-oss-120b y MoE de 122B enteros en la GPU.
GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.6 27B
El clásico del homelab: 24 GB y 936 GB/s, comprada de segunda mano. Con dos tienes 48 GB.
GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.6 35B A3B
48 GB en una tarjeta de turbina de 300 W: modelos densos de 70B en una sola GPU.

GPU NVIDIA
Mayor modelo popular a 4 bits: gpt-oss-20b
La NVIDIA nueva más barata con 16 GB. Bajo consumo y CUDA: la forma fácil de empezar.
GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.6 27B
24 GB en una tarjeta de una ranura y 140 W: la forma más «homelab» de tener 24 GB nuevos.
GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.6 35B A3B
32 GB con solo 200 W: la capacidad de una RTX 5090 con la mitad de calor.
GPU NVIDIA
Mayor modelo popular a 4 bits: Qwen3.6 27B
Ya no se fabrica, pero sigue siendo de las mejores para IA: 24 GB a 1 TB/s.
GPU NVIDIA
Mayor modelo popular a 4 bits: gpt-oss-20b
Casi el ancho de banda de la RTX 5080 por menos dinero. Sigue teniendo 16 GB: velocidad, no tamaño.

GPU NVIDIA
Mayor modelo popular a 4 bits: Gemma 4 12B
La forma más barata de tener CUDA con 12 GB. Lenta, pero suficiente para modelos de 7–12B.
GPU NVIDIA
Mayor modelo popular a 4 bits: gpt-oss-20b
Rápida, pero solo 16 GB: la misma memoria que tarjetas que cuestan un tercio.
GPU NVIDIA
Mayor modelo popular a 4 bits: Gemma 4 12B
Una tarjeta para jugar con solo 12 GB. Para IA compensa más la RTX 5060 Ti de 16 GB.