DGX Spark / GB10 vs Ryzen AI Max+ 395
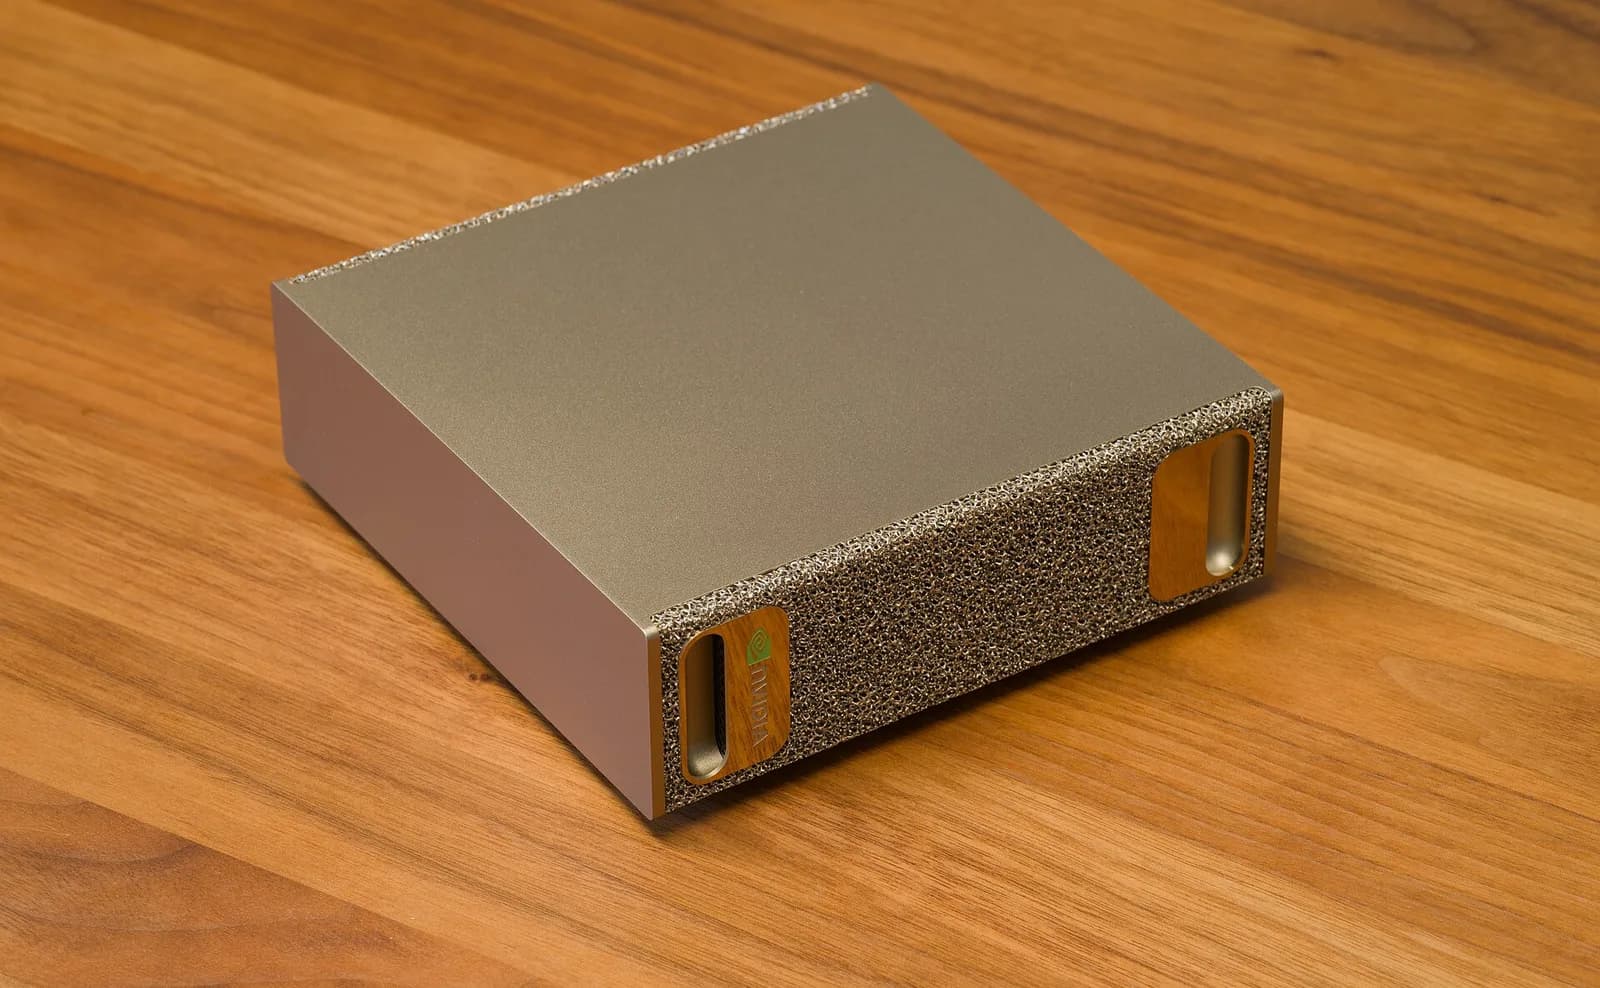
Recomendable
Foto: Daniel Lu (User:dllu) · CC BY-SA 4.0

Ilustración
Muy recomendable
Nuestro veredicto
OpiniónNuestro veredicto
La misma memoria (128 GB) y casi el mismo ancho de banda (273 frente a 256 GB/s): generan texto a ritmo parecido. GB10 gana en software (CUDA, vLLM, ajuste fino) y en procesar prompts; Strix Halo gana en precio y es un PC x86 normal. Para chatear y usar agentes en casa compensa más Strix Halo; para desarrollar con CUDA, GB10.
| Datos | DGX Spark / GB10 | Ryzen AI Max+ 395 |
|---|---|---|
| Memoria (máxima) | 128 GB | 128 GB |
| Utilizable para modelos | 115 GB | 115 GB |
| Ancho de banda | 273 GB/sMás | 256 GB/s |
| Mayor modelo popular a 4 bits | Qwen3.5 122B A10B | Qwen3.5 122B A10B |
| Precio desde | 5000 US$ | 2200 US$Ventaja |
| Precio por GB | 39 US$ | 19 US$Ventaja |
| Consumo | 240 W | 120 W |
| Plataforma de cálculo | CUDA (Arm) | ROCm / Vulkan |
Qué modelos ejecuta cada uno
Modelos populares a Q4_K_M con un contexto de 32K tokens. La memoria necesaria sale de los archivos reales del modelo; la velocidad es el techo teórico.
| Modelo | DGX Spark / GB10 | Ryzen AI Max+ 395 |
|---|---|---|
| Qwen3 1.7B | Funciona≤ 246 tok/s | Funciona≤ 231 tok/s |
| Qwen3.5 9B | Funciona≤ 48 tok/s | Funciona≤ 45 tok/s |
| Gemma 4 12B | Funciona≤ 38 tok/s | Funciona≤ 36 tok/s |
| gpt-oss-20b | Funciona≤ 136 tok/s | Funciona≤ 128 tok/s |
| Qwen3.6 27B | Funciona≤ 16 tok/s | Funciona≤ 15 tok/s |
| Qwen3.6 35B A3B | Funciona≤ 148 tok/s | Funciona≤ 139 tok/s |
| Llama 3.3 70B | Funciona≤ 6 tok/s | Funciona, justo≤ 6 tok/s |
| gpt-oss-120b | Funciona≤ 100 tok/s | Funciona≤ 93 tok/s |
| Qwen3.5 122B A10B | Funciona≤ 45 tok/s | Funciona≤ 42 tok/s |
| Qwen3.5 397B A17B | No tiene memoria suficiente | No tiene memoria suficiente |
Los techos de velocidad son teóricos; mira cada ficha para ver resultados medidos.